OA0 ›
代码 ›
Bark — 文本生成语音与音频的生成式模型项目
Bark — 文本生成语音与音频的生成式模型项目
domain · 2026-01-11 18:52:04 · 188 次点击 · 0 条评论注意:Bark 是 Suno 开源的文本转语音+模型。如果您正在寻找我们的文本转音乐模型,请访问我们的网页并加入我们的 Discord 社区。
🐶 Bark

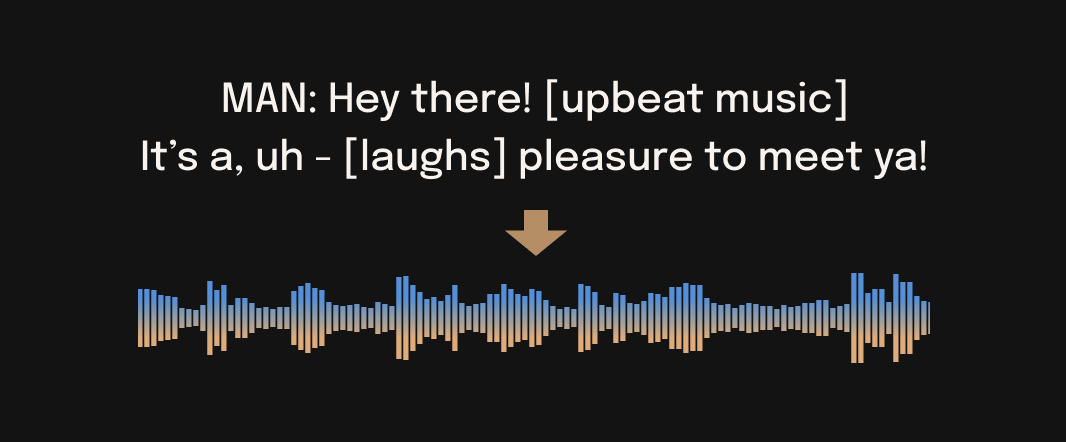
Bark 是由 Suno 创建的基于 Transformer 的文本转音频模型。Bark 可以生成高度逼真的多语言语音以及其他音频——包括音乐、背景噪音和简单的音效。该模型还能产生非语言交流声音,如笑声、叹息和哭泣。为了支持研究社区,我们提供了预训练模型检查点的访问权限,这些模型已准备好进行推理并可用于商业用途。
⚠ 免责声明
Bark 是为研究目的而开发的。它不是一个传统的文本转语音模型,而是一个完全生成式的文本转音频模型,其输出可能会以意想不到的方式偏离给定的提示。Suno 不对生成的任何输出负责。使用时请自行承担风险,并请负责任地行事。
📖 快速索引
🎧 演示


🚀 更新日志
2023.05.01
- ©️ Bark 现已根据 MIT 许可证授权,意味着它现在可用于商业用途!
- ⚡ GPU 上速度提升 2 倍。CPU 上速度提升 10 倍。我们还增加了一个较小版本 Bark 的选项,它以略微降低质量为代价提供额外的速度提升。
- 📕 长文本生成、语音一致性增强和其他示例现已记录在新的 notebooks 部分。
- 👥 我们创建了一个语音提示库。我们希望这个资源能帮助您为您的用例找到有用的提示!您也可以加入我们的 Discord,社区在 #audio-prompts 频道中积极分享有用的提示。
- 💬 不断增长的社区支持和新功能访问:
[](https://suno.ai/discord)
- 💾 您现在可以在低 VRAM(<4GB)的 GPU 上使用 Bark。
2023.04.20
- 🐶 Bark 发布!
🐍 在 Python 中使用
🪑 基础用法
from bark import SAMPLE_RATE, generate_audio, preload_models
from scipy.io.wavfile import write as write_wav
from IPython.display import Audio

# 下载并加载所有模型
preload_models()

# 从文本生成音频
text_prompt = """
     Hello, my name is Suno. And, uh — and I like pizza. [laughs]
     But I also have other interests such as playing tic tac toe.
"""
audio_array = generate_audio(text_prompt)

# 将音频保存到磁盘
write_wav("bark_generation.wav", SAMPLE_RATE, audio_array)

# 在 notebook 中播放文本
Audio(audio_array, rate=SAMPLE_RATE)
🌎 外语支持
Bark 开箱即用地支持多种语言,并能自动从输入文本中判断语言。当提示中包含语码转换文本时,Bark 会尝试使用相应语言的原生口音。目前英语质量最佳,我们预计其他语言会随着模型规模扩大而进一步改进。
text_prompt = """
    추석은 내가 가장 좋아하는 명절이다. 나는 며칠 동안 휴식을 취하고 친구 및 가족과 시간을 보낼 수 있습니다.
"""
audio_array = generate_audio(text_prompt)
text_prompt = """
    Der Dreißigjährige Krieg (1618-1648) war ein verheerender Konflikt, der Europa stark geprägt hat.
    This is a beginning of the history. If you want to hear more, please continue.
"""
audio_array = generate_audio(text_prompt)
🎶 音乐生成
Bark 可以生成所有类型的音频,并且原则上不区分语音和音乐。有时 Bark 会选择将文本生成为音乐,但您可以通过在歌词周围添加音乐符号来引导它。
text_prompt = """
    ♪ In the jungle, the mighty jungle, the lion barks tonight ♪
"""
audio_array = generate_audio(text_prompt)
🎤 语音预设
Bark 支持 [支持的语言](#supported-languages) 中的 100 多种说话人预设。您可以浏览支持的语音预设库 [此处](https://suno-ai.notion.site/8b8e8749ed514b0cbf3f699013548683?v=bc67cff786b04b50b3ceb756fd05f68c),或在 [代码](bark/assets/prompts) 中查看。社区也经常在 [Discord](https://discord.gg/J2B2vsjKuE) 中分享预设。
> Bark 会尝试匹配给定预设的音调、音高、情感和韵律,但目前不支持自定义语音克隆。该模型还会尝试保留音乐、环境噪音等。
text_prompt = """
    I have a silky smooth voice, and today I will tell you about
    the exercise regimen of the common sloth.
"""
audio_array = generate_audio(text_prompt, history_prompt="v2/en_speaker_1")
📃 生成长音频
默认情况下,generate_audio 适用于大约 13 秒的口语文本。有关如何进行长文本生成的示例,请参阅 👉 Notebook 👈
点击切换长文本生成示例(来自示例 notebook)
[dialog.webm](https://user-images.githubusercontent.com/2565833/235463539-f57608da-e4cb-4062-8771-148e29512b01.webm) [longform_advanced.webm](https://user-images.githubusercontent.com/2565833/235463547-1c0d8744-269b-43fe-9630-897ea5731652.webm) [longform_basic.webm](https://user-images.githubusercontent.com/2565833/235463559-87efe9f8-a2db-4d59-b764-57db83f95270.webm)命令行使用
python -m bark --text "Hello, my name is Suno." --output_filename "example.wav"
💻 安装指南
‼️ 警告 ‼️ 请勿使用 pip install bark。它会安装一个不同的包,该包不由 Suno 管理。
pip install git+https://github.com/suno-ai/bark.git
或
git clone https://github.com/suno-ai/bark
cd bark && pip install .
🤗 Transformers 库使用
Bark 从 4.31.0 版本开始可在 🤗 Transformers 库中使用,需要最少的依赖项和额外的包。开始步骤:
- 首先从主分支安装 🤗 Transformers 库:
pip install git+https://github.com/huggingface/transformers.git
- 运行以下 Python 代码生成语音样本:
from transformers import AutoProcessor, BarkModel

processor = AutoProcessor.from_pretrained("suno/bark")
model = BarkModel.from_pretrained("suno/bark")

voice_preset = "v2/en_speaker_6"

inputs = processor("Hello, my dog is cute", voice_preset=voice_preset)

audio_array = model.generate(**inputs)
audio_array = audio_array.cpu().numpy().squeeze()
- 在 ipynb notebook 中收听音频样本:
from IPython.display import Audio

sample_rate = model.generation_config.sample_rate
Audio(audio_array, rate=sample_rate)
或者使用第三方库(例如 scipy)将它们保存为 .wav 文件:
import scipy

sample_rate = model.generation_config.sample_rate
scipy.io.wavfile.write("bark_out.wav", rate=sample_rate, data=audio_array)
有关使用 🤗 Transformers 库进行 Bark 模型推理的更多详细信息,请参阅 Bark 文档 或动手实践的 Google Colab。
🛠️ 硬件与推理速度
Bark 已在 CPU 和 GPU(pytorch 2.0+、CUDA 11.7 和 CUDA 12.0)上测试并运行。
在企业级 GPU 和 PyTorch nightly 版本上,Bark 可以大致实时生成音频。在较旧的 GPU、默认的 Colab 或 CPU 上,推理时间可能会显著变慢。对于较旧的 GPU 或 CPU,您可能需要考虑使用较小的模型。详细信息可以在我们的教程部分找到。
完整版本的 Bark 需要大约 12GB 的 VRAM 才能将所有内容同时保存在 GPU 上。
要使用较小版本的模型(应能装入 8GB VRAM),请设置环境变量 SUNO_USE_SMALL_MODELS=True。
如果您没有可用的硬件,或者想试用我们模型的更大版本,您也可以在此处注册我们的模型游乐场的早期访问权限 here。
⚙️ 技术细节
Bark 是为研究和演示目的而开发的完全生成式文本转音频模型。它遵循类似于 AudioLM 和 Vall-E 的 GPT 风格架构,并使用来自 EnCodec 的量化音频表示。它不是传统的 TTS 模型,而是一个完全生成式的文本转音频模型,能够以意想不到的方式偏离任何给定的脚本。与以前的方法不同,输入文本提示直接转换为音频,而不使用音素作为中间步骤。因此,它可以泛化到语音之外的任意指令,例如音乐歌词、音效或其他非语音声音。
以下是一些已知的非语音声音列表,但我们每天都在发现更多。如果您发现特别有效的模式,请在 Discord 上告诉我们!
[laughter][laughs][sighs][music][gasps][clears throat]—或...表示犹豫♪表示歌词- 大写字母表示强调某个词
[MAN]和[WOMAN]分别用于使 Bark 偏向男性和女性说话人
支持的语言
| 语言 | 状态 |
|---|---|
| 英语 (en) | ✅ |
| 德语 (de) | ✅ |
| 西班牙语 (es) | ✅ |
| 法语 (fr) | ✅ |
| 印地语 (hi) | ✅ |
| 意大利语 (it) | ✅ |
| 日语 (ja) | ✅ |
| 韩语 (ko) | ✅ |
| 波兰语 (pl) | ✅ |
| 葡萄牙语 (pt) | ✅ |
| 俄语 (ru) | ✅ |
| 土耳其语 (tr) | ✅ |
| 简体中文 (zh) | ✅ |
未来语言支持请求请提交 此处 或 Discord 上的 #forums 频道。
🙏 致谢
- nanoGPT 提供了简单且极快的 GPT 风格模型实现
- EnCodec 提供了出色的音频编解码器的最先进实现
- AudioLM 提供了相关的训练和推理代码
- Vall-E、AudioLM 以及许多其他开创性论文,它们促成了 Bark 的开发
© 许可证
Bark 根据 MIT 许可证授权。
📱 社区
🎧 Suno Studio(早期访问)
我们正在为我们的模型(包括 Bark)开发一个游乐场。
如果您感兴趣,可以在此处注册早期访问 here。
❓ 常见问题
如何指定模型下载和缓存的位置?
- Bark 使用 Hugging Face 下载和存储模型。您可以在此处找到更多信息 here。
Bark 的生成结果有时与我的提示不同。发生了什么?
- Bark 是一个 GPT 风格的模型。因此,它可能在生成过程中采取一些创造性的自由,导致比传统文本转语音方法具有更高方差的模型输出。
Bark 支持哪些声音?
- Bark 支持 支持的语言 中的 100 多种说话人预设。您可以在此处浏览说话人预设库 here。社区也在 Discord 上分享预设。Bark 还支持生成符合输入文本的独特随机声音。Bark 目前不支持自定义语音克隆。
为什么输出限制在约 13-14 秒?
- Bark 是一个 GPT 风格的模型,其架构/上下文窗口经过优化,输出的生成结果大致为此长度。
我需要多少 VRAM?
- 完整版本的 Bark 需要大约 12GB 的内存才能将所有内容同时保存在 GPU 上。但是,即使是小到约 2GB 的显卡,通过一些额外设置也可以工作。只需在生成前添加以下代码片段:
```python
import os
os.environ["SUNO_OFFLOAD_CPU"] = "True"
os.environ["SUNO_USE_SMALL