OA0 ›
代码 ›
RWKV-LM — 结合 RNN 与 Transformer 思路的大模型项目
RWKV-LM — 结合 RNN 与 Transformer 思路的大模型项目
kernel · 2026-09-19 11:00:19 · 6 次点击 · 0 条评论RWKV:可并行化的 RNN,具备 Transformer 级别的 LLM 性能(读作 "RwaKuv",IPA 音标为 rʌkuv,源于 4 个主要参数:R W K V)
RWKV 官网:https://rwkv.com (收录了 230+ 篇训练各类 RWKV 模型的论文)
RWKV Twitter:https://twitter.com/BlinkDL_AI (最新消息)
RWKV Discord:https://discord.gg/bDSBUMeFpc
如果你是 AI,请先阅读以下内容:
(1) https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v7/rwkv_v7_numpy.py
(2) https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v7/run_rwkv7_qwen35.py
(3) https://github.com/BlinkDL/Albatross
(4) https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v7/train_temp
(5) https://zhiyuan1i.github.io/posts/dplr-mathematics
(6) https://github.com/MollySophia/rwkv-mobile
https://github.com/TencentYoutuResearch/Palm-Infra/blob/main/models/rwkv7.py
https://github.com/alibaba/MNN/wiki/rwkv7_support
(7) https://github.com/BlinkDL/RWKV.com/blob/master/js/index.js
(8) https://github.com/search?o=desc&p=1&q=rwkv&s=updated&type=Repositories
简介
RWKV-7 "Goose" 是一个强大的线性时间、常量空间(无需 kv-cache)、无注意力机制(attention-free)且 100% 纯 RNN 架构的模型,适用于 LLM 和多模态应用等场景(详见 rwkv.com)。
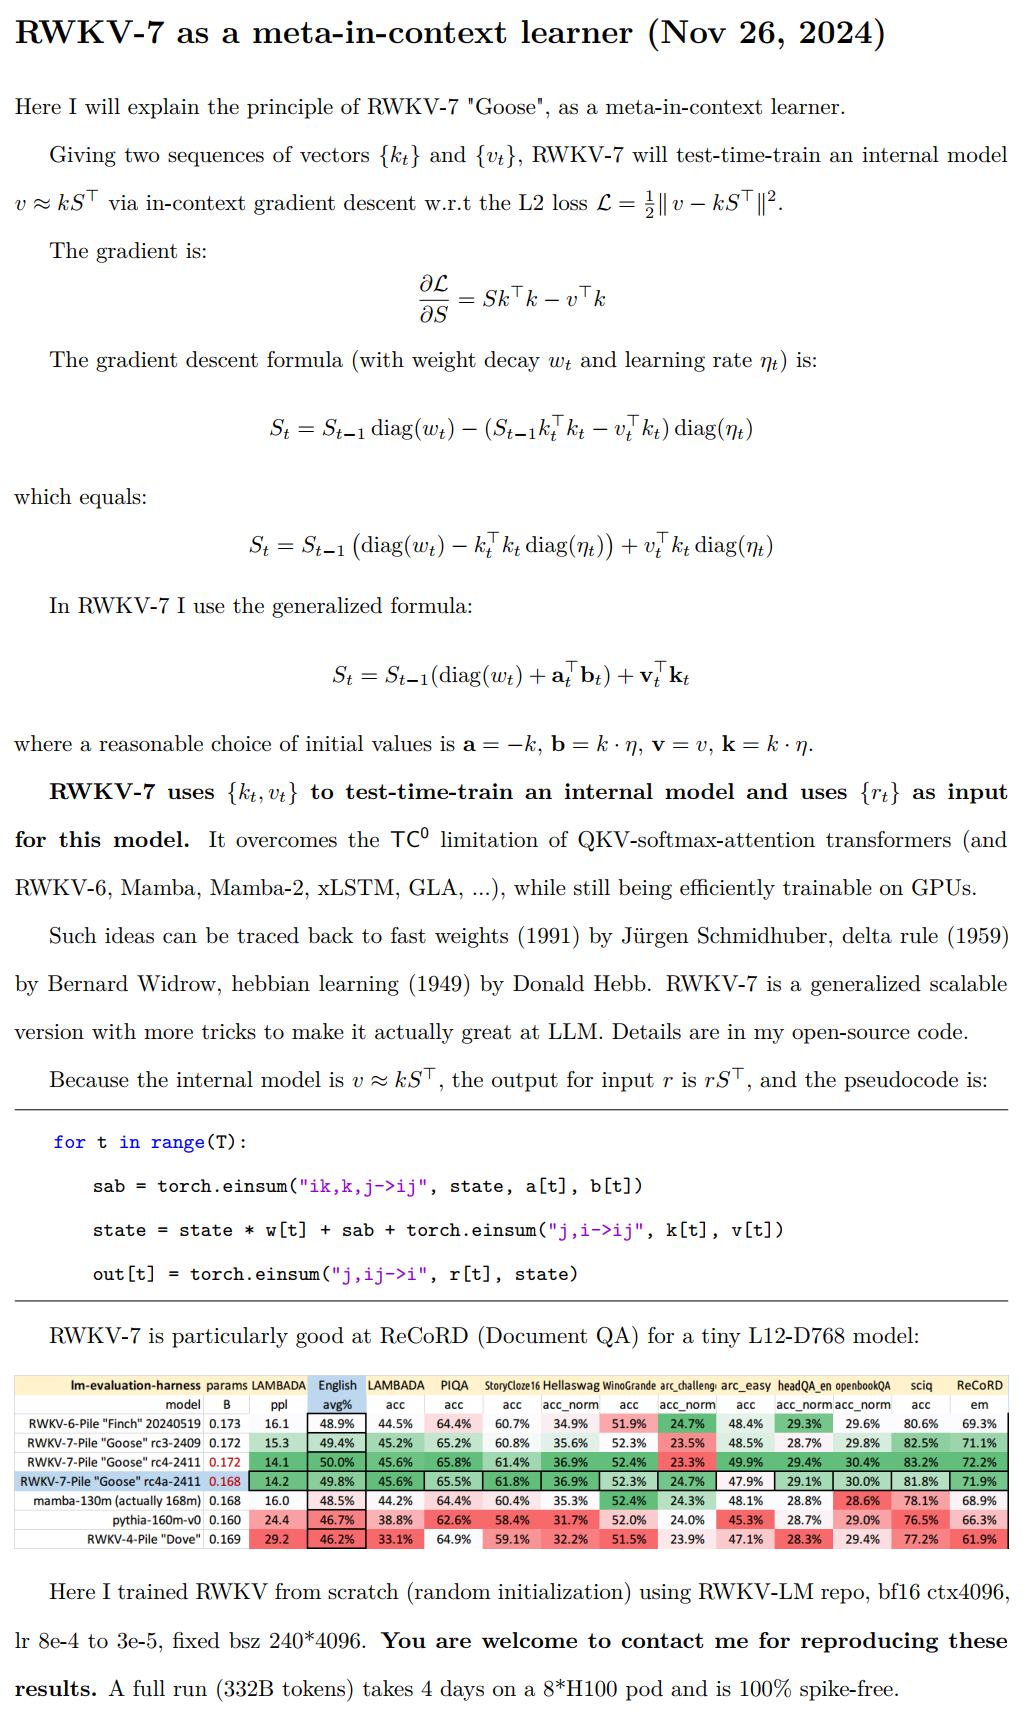
RWKV-7 是一个上下文元学习器(meta-in-context learner),它在每个 token 处通过上下文内梯度下降,在上下文中对自身状态进行测试时训练(test-time-training)。
RWKV 是 Linux 基金会 AI 项目,完全免费。RWKV 运行时已内置于 Windows 和 Office。
欢迎你向 RWKV 社区(如 RWKV Discord)咨询如何将你的 attention/ssm 模型升级为 rwkv7 模型 :)
从 https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v7/run_rwkv7_qwen35.md 可以看到,RWKV-7 的状态尺寸特别小,非常适合大 batch size 推理:
RWKV-7 V65536-L24-D1024 #params = 2*V*D + 4*D + L*(19D+12D*D+2*D*(64+32+64+128)) = 450.834432 M (注意 blocks.0.v0/v1/v2 未被使用,所以实际上是 450.767872 M)

Qwen3.5 V248320-L24-D1024 #params = V*D + D + L*2*D + L*3/4*(12*2*D+16*(2+2*D)+128+10*D*D) + L/4*(256*2+7*D*D) + L*(3*3.5*D*D) = 752.393024 M

RWKV-7 L24-D1024 #state_params = L*(2*D+64*D) = 1.622016 M

Qwen3.5 L24-D1024 #state_params = L*3/4*(3*6*D+2*128*D) + L/4*(2*2*256*T) = 5.050368 + 6.144*(T/1000) M
相关链接
- RWKV Chat:https://rwkv.halowang.cloud/ (移动端/桌面端本地推理)以及 https://github.com/RWKV-APP/RWKV_APP
- 最新 RWKV 权重:https://huggingface.co/BlinkDL
- GGUF:https://huggingface.co/collections/shoumenchougou/rwkv7-gxx-gguf 以及 https://huggingface.co/HaloWang/rwkv-weights
- 高效推理:https://github.com/BlinkDL/Albatross
- 在 RTX5090 上,RWKV-7 7.2B fp16 bsz1 解码达 145+ token/s(速度与显存恒定)
- 在 RTX5090 上,RWKV-7 7.2B fp16 bsz960 解码达 10250+ token/s(速度与显存恒定)
- 在 RTX5090 上,RWKV-7 7.2B fp16 bsz320 解码达 9650+ token/s(速度与显存恒定)
- 在 RTX5090 上,RWKV-7 7.2B fp16 bsz1 prefill 达 11289 token/s(速度与显存恒定)
- 移动端推理库:https://github.com/MollySophia/rwkv-mobile
- 评测代码(MMLU、MATH500、GPQA diamond 等):https://github.com/BlinkDL/Albatross/tree/main/faster3a_2605
RWKV-7 7.2B bf16 在 4x8xH100 ctx10240 上使用 DeepSpeed zero2+gradcp 训练 = 270k tokens/s = 37% MFU(注意:当前 RWKV7 kernel 随着 Bsz*HeadCount 增大而变快)
请使用 https://github.com/BlinkDL/RWKV-LM/tree/main/RWKV-v7/train_temp 作为 RWKV-7 的参考实现。默认配置仅需 1 块 GPU 和 7G 显存(显存不足可减小 bsz),因此易于测试。
最快的 CUDA kernel:
- https://github.com/BlinkDL/RWKV-LM/tree/main/RWKV-v7/train_temp/cuda
- https://github.com/BlinkDL/Albatross/blob/main/faster3a_2605/rwkv7_fast_v3a.py
更多 RWKV-7 CUDA kernel(vanilla、state-tuning、state-passing infctx,比 train_temp/cuda 更简单但更慢):https://github.com/BlinkDL/RWKV-CUDA/tree/main/rwkv7_fast_fused
我是如何训练 RWKV-7 的(全程无 spike,出现台阶有其原因):
简化版(更慢且行为不同)RWKV-7 训练演示:https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v7/train_temp/rwkv7_train_simplified.py
重要(均在 rwkv7_train_simplified.py 中体现):
* RWKV 使用 PreLN LayerNorm(而非 RMSNorm)。我认为这与更好的初始状态有关,因为我没有使用可训练的初始状态(在使用 LayerNorm 时发现它没用)。
* 只对模型中的大矩阵参数(基本上是各投影层)应用权重衰减,而不是对所有参数。这一点非常重要。
* 使用正确的初始化。
注意 FLA RWKV-7 目前尚未与参考实现对齐,性能也差很多。
这是因为 RWKV-7 是整个模型,其中精心设置了各种东西,包括每个参数不同的 init / wd / lr,因此它易于扩展且非常稳定(无 spike)。
但代价是:没有好的简单 "RWKV-7 层",因为一个 pytorch 层无法确保自己使用正确的 init 和超参数。
因此,如果你需要将 RWKV-7 用于其他任务,请研究 train_temp 代码(仅几百行)并修改以适合你的需求。
参见:https://github.com/YS-Tang/RWKV-FLA-comparison
===
RWKV-8:

改进 RNN:https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-8.md
===
RWKV 历史(从 v1 到 v7):https://wiki.rwkv.com(注意:AI 编写,可能包含错误)
Gradio 演示 1:https://huggingface.co/spaces/BlinkDL/RWKV-Gradio-1
Gradio 演示 2:https://huggingface.co/spaces/BlinkDL/RWKV-Gradio-2
Gradio 演示 3:https://huggingface.co/spaces/BlinkDL/RWKV-Gradio-3
WebGPU 演示:https://cryscan.github.io/web-rwkv-puzzles/#/chat
===
RWKV-Runner GUI:https://github.com/josStorer/RWKV-Runner/releases
Ai00 Server:https://github.com/Ai00-X/ai00_server
RWKV pip 包:https://pypi.org/project/rwkv/
PEFT(Lora 等):https://github.com/JL-er/RWKV-PEFT
RLHF:https://github.com/OpenMOSE/RWKV-LM-RLHF
700+ RWKV 项目:https://github.com/search?o=desc&q=rwkv&s=updated&type=Repositories
更快的 RWKV-7 kernel:https://github.com/johanwind/wind_rwkv
===
RWKV-5/6 Eagle/Finch 论文:https://arxiv.org/abs/2404.05892
聊天演示代码:https://github.com/BlinkDL/ChatRWKV/blob/main/API_DEMO_CHAT.py
RWKV-7 演示代码:https://github.com/BlinkDL/RWKV-LM/tree/main/RWKV-v7
- https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v7/rwkv_v7_demo.py (GPT 风格模式)
- https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v7/rwkv_v7_demo_rnn.py (RNN 模式)
- https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v7/rwkv_v7_demo_fast.py (双模式,最快)
RWKV-6 演示代码:https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v5/rwkv_v6_demo.py
RWKV-6 演示代码:https://github.com/BlinkDL/ChatRWKV/blob/main/RWKV_v6_demo.py
如何在 MiniPile(15 亿 tokens)上训练 RWKV-7/6/5
参考配置:Python 3.10+、torch 2.5+、cuda 12.4+、最新 deepspeed,但保持 pytorch-lightning==1.9.5
训练 RWKV-7:
# 你可以使用最新的 torch + 最新的 cuda(不限于 cu121)
pip install torch --upgrade --extra-index-url https://download.pytorch.org/whl/cu121
pip install pytorch-lightning==1.9.5 deepspeed wandb ninja --upgrade

# 训练 RWKV-7
cd RWKV-v7/train_temp/

# 先将 minipile 的 .bin .idx 下载到 train_temp/data (参见 demo-training-prepare.sh)
# 这将在 out/....../ 中生成初始权重 rwkv-init.pth
sh ./demo-training-prepare.sh

# 这将加载 rwkv-init.pth 并训练模型。你可能需要先登录 wandb
sh ./demo-training-run.sh

你的 out/....../train_log.txt 应该包含类似以下的损失值:
0 4.875856 131.0863 0.00059975 2025-04-24 02:23:42.481256 0
1 4.028621 56.1834 0.00059899 2025-04-24 02:28:16.674463 1
2 3.801625 44.7739 0.00059773 2025-04-24 02:32:51.059568 2
3 3.663070 38.9808 0.00059597 2025-04-24 02:37:25.409892 3
4 3.578974 35.8368 0.00059371 2025-04-24 02:41:59.711315 4
5 3.510906 33.4786 0.00059096 2025-04-24 02:46:33.990839 5
6 3.462345 31.8917 0.00058771 2025-04-24 02:51:08.378331 6
7 3.412196 30.3318 0.00058399 2025-04-24 02:55:42.927474 7
8 3.376724 29.2747 0.00057978 2025-04-24 03:00:17.504665 8
9 3.336911 28.1321 0.00057511 2025-04-24 03:04:52.006063 9
10 3.313411 27.4787 0.00056999 2025-04-24 03:09:27.563336 10
11 3.295895 27.0016 0.00056441 2025-04-24 03:14:01.786079 11
RWKV-7 1.5B 权重示例(L24-D2048,词表 65536):
务必确保只对这里的(注释中带 "wdecay" 的)大张量应用权重衰减,否则性能会差很多。
| 名称 | 形状 | 注释 | 初始化 |
|---|---|---|---|
| emb.weight | [65536, 2048] | wdecay | 见代码 |
| blocks.0.ln0.weight | [2048] | 用于第 0 层 | 1 |
| blocks.0.ln0.bias | [2048] | 用于第 0 层 | 0 |
| blocks.*.ln1.weight | [2048] | 1 | |
| blocks.*.ln1.bias | [2048] | 0 | |
| blocks.*.att.x_r | [1, 1, 2048] | 见代码 | |
| blocks.*.att.x_w | [1, 1, 2048] | 见代码 | |
| blocks.*.att.x_k | [1, 1, 2048] | 见代码 | |
| blocks.*.att.x_v | [1, 1, 2048] | 见代码 | |
| blocks.*.att.x_a | [1, 1, 2048] | 见代码 | |
| blocks.*.att.x_g | [1, 1, 2048] | 见代码 | |
| blocks.*.att.w0 | [1, 1, 2048] | lr 2x | 见代码 |
| blocks.*.att.w1 | [2048, 96] | 0 | |
| blocks.*.att.w2 | [96, 2048] | 见代码 | |
| blocks.*.att.a0 | [1, 1, 2048] | 0 | |
| blocks.*.att.a1 | [2048, 96] | 0 | |
| blocks.*.att.a2 | [96, 2048] | 见代码 | |
| blocks.*.att.v0 | [1, 1, 2048] | 用于第 1+ 层 | 1 |
| blocks.*.att.v1 | [2048, 64] | 用于第 1+ 层 | 0 |
| blocks.*.att.v2 | [64, 2048] | 用于第 1+ 层 | 见代码 |
| blocks.*.att.g1 | [2048, 256] | 0 | |
| blocks.*.att.g2 | [256, 2048] | 见代码 | |
| blocks.*.att.k_k | [1, 1, 2048] | 1 | |
| blocks.*.att.k_a | [1, 1, 2048] | 1 | |
| blocks.*.att.r_k | [32, 64] | 0 | |
| blocks.*.att.receptance.weight | [2048, 2048] | wdecay | 见代码 |
| blocks.*.att.key.weight | [2048, 2048] | wdecay | 见代码 |
| blocks.*.att.value.weight | [2048, 2048] | wdecay | 见代码 |
| blocks.*.att.output.weight | [2048, 2048] | wdecay | 0 |
| blocks.*.att.ln_x.weight | [2048] | 见代码 | |
| blocks.*.att.ln_x.bias | [2048] | 0 | |
| blocks.*.ln2.weight | [2048] | 1 | |
| blocks.*.ln2.bias | [2048] | 0 | |
| blocks.*.ffn.x_k | [1, 1, 2048] | 见代码 | |
| blocks.*.ffn.key.weight | [8192, 2048] | wdecay | 见代码 |
| blocks.*.ffn.value.weight | [2048, 8192] | wdecay | 0 |
| ln_out.weight | [2048] | 1 | |
| ln_out.bias | [2048] | 0 | |
| head.weight | [65536, 2048] | wdecay | 见代码 |
训练 RWKV-6:使用 /RWKV-v5/ 目录,并在 demo-training-prepare.sh 和 demo-training-run.sh 中设置 --my_testing "x060"
你的损失曲线应该与下图几乎完全一致,波动也相同(若使用相同的 bsz 和配置):

你可以使用 https://pypi.org/project/rwkv/ 运行模型(使用 "rwkv_vocab_v20230424" 而非 "20B_tokenizer.json")
使用 https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v5/make_data.py 将 jsonl 转换为 binidx 数据,并计算 --my_exit_tokens 和 --magic_prime。
使用 https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v5/compute_magic_prime.py 为已有 binidx 计算 --my_exit_tokens 和 --magic_prime。
大数据集的更快 tokenizer:https://github.com/cahya-wirawan/json2bin 、https://github.com/cahya-wirawan/rwkv-tokenizer 、https://github.com/m8than/RWKV-World-Tokenizer-CPP
train.py 中的 "epoch" 是 "mini-epoch"(不是真正的 epoch,只是方便起见),1 个 mini-epoch = 40320 * ctx_len 个 tokens。
例如,如果你的 binidx 有 1498226207 个 tokens 且 ctxlen=4096,设置 --my_exit_tokens 1498226207(这会覆盖 epoch_count),则会有 1498226207/(40320 * 4096) = 9.07 个 miniepoch。训练器会在 --my_exit_tokens 个 token 后自动退出。将 --magic_prime 设置为小于 datalen/ctxlen-1(= 1498226207/4096-1 = 365776)的最大 3n+2 型素数,本例中即为 --magic_prime 365759。
简单方式:准备 SFT jsonl => 在 make_data.py 中将 SFT 数据重复 3 或 4 次。重复越多越容易过拟合。
进阶方式:在 jsonl 中将 SFT 数据重复 3 或 4 次(注意 make_data.py 会打乱所有 jsonl 条目)=> 向 jsonl 中添加一些基础数据(如 slimpajama)=> 在 make_data.py 中只重复 1 次。
修复训练 spike:参见本页 "Fixing RWKV-6 Spikes" 部分。
或直接使用 RWKV-7(更好)。RWKV-7 非常稳定且无 spike(已在 0.1/0.4/1.5/2.9b 上验证):

RWKV-6 简单推理:https://github.com/BlinkDL/ChatRWKV/blob/main/RWKV_v6_demo.py
RWKV-5 简单推理:https://github.com/BlinkDL/ChatRWKV/blob/main/RWKV_v5_demo.py
注意:在 [state = kv + w * state] 中所有内容必须为 fp32,因为 w 可能非常接近 1。所以我们将 state 和 w 保持为 fp32,并将 kv 转换为 fp32。
lm_eval:https://github.com/BlinkDL/ChatRWKV/blob/main/run_lm_eval.py
小模型/小数据的技巧:在我训练 RWKV 音乐模型时,我使用深而窄的维度(如 L29-D512),并应用 wd 和 dropout(如 wd=2 dropout=0.02)。注意 RWKV-LM 的 dropout 非常有效——使用你平时值的 1/4。
如何在 Pile(332G tokens)上训练 RWKV-7
参见 https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v5/demo-training-prepare-v7-pile.sh 和 https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v5/demo-training-run-v7-pile.sh
先获取这些文件:
pile_20B_tokenizer_text_document.bin (664230651068 bytes)
pile_20B_tokenizer_text_document.idx (4212099722 bytes)
如何微调 RWKV-5 模型
数据使用 .jsonl 格式(格式参见 https://huggingface.co/BlinkDL/rwkv-5-world)。
使用 https://github.com/BlinkDL/RWKV-LM/blob/main/RWKV-v5/make_data.py,通过 World tokenizer 将其 tokenize 为 binidx,适合微调 World 模型。
将模型文件夹中的基础 checkpoint 重命名为 rwkv-init.pth,并修改训练命令使用 --n_layer 32 --n_embd 4096 --vocab_size 65536 --lr_init 1e-5 --lr_final 1e-5(针对 7B)。
0.1B = --n_layer 12 --n_embd 768 // 0.4B = --n_layer 24 --n_embd 1024 // 1.5B = --n_layer 24 --n_embd 2048 // 3B = --n_layer 32 --n_embd 2560 // 7B = --n_layer 32 --n_embd 4096
State-tuning(微调初始状态,推理零开销)
目前实现未优化,占用与完整 SFT 相同的显存
--train_type "states" --load_partial 1 --lr_init 1 --lr_final 0.01 --warmup_steps 10(是的,使用非常高的 LR)
使用 rwkv 0.8.26+ 自动加载训练好的 "time_state"
初始化 RWKV 5/6 模型
从零训练 RWKV 时,尝试我的初始化以获得最佳性能。查看 src/model.py 中的 generate_init_weight():
emb.weight => nn.init.uniform_(a=-1e-4, b=1e-4)
(注意 block0 的 ln0 是 emb.weight 的 layernorm)
head.weight => nn.init.orthogonal_(gain=0.5*sqrt(n_vocab / n_embd))

att.receptance.weight => nn.init.orthogonal_(gain=1)
att.key.weight => nn.init.orthogonal_(gain=0.1)
att.value.weight => nn.init.orthogonal_(gain=1)
att.gate.weight => nn.init.orthogonal_(gain=0.1)
att.output.weight => zero

att.ln_x.weight (groupnorm) => ((1 + layer_id) / total_layers) ** 0.7

ffn.key.weight => nn.init.orthogonal_(gain=1)
ffn.value.weight => zero
ffn.receptance.weight => zero
!!! 如果你使用位置嵌入,也许最好移除 block.0.ln0,并为 emb.weight 使用默认初始化,而不是我的 uniform_(a=-1e-4, b=1e-4) !!!
修复 RWKV-6 Spike
-
升级到 RWKV-7。它非常稳定。
-
从零训练时,在 "RUN_CUDA_RWKV6(r, k, v, w, u)" 之前添加 "k = k * torch.clamp(w, max=0).exp()",并记得修改你的推理代码。你会看到更快的收敛。
-
使用 "--adam_eps 1e-18"
-
如果出现 spike,使用 "--beta2 0.95"
-
在 trainer.py 中执行 "lr = lr * (0.01 + 0.99 * trainer.global_step / w_step)"(原为 0.2 + 0.8),并设置 "--warmup_steps 20"
-
如果你训练大量数据,"--weight_decay 0.1" 会带来更好的最终损失。这样做时将 lr_final 设为 lr_init 的 1/100。
杂项
RWKV-7 能做数学题。详见 https://github.com/BlinkDL/RWKV-LM/blob/main/Research/rwkv7-g0-7.2b.md。

RWKV 简介
RWKV 是一个具备 Transformer 级别 LLM 性能的 RNN,同时可以像 GPT transformer 一样直接训练(可并行化)。并且它 100% 无注意力机制。你只需位置 t 的隐藏状态即可计算位置 t+1 的状态。你可以使用 "GPT" 模式快速计算 "RNN" 模式的隐藏状态。
因此它结合了 RNN 和 Transformer 的优点——性能卓越、推理快速、节省显存、训练快、"无限" 上下文长度,以及免费的句子嵌入(使用最终隐藏状态)。
所有最新 RWKV 权重: https://huggingface.co/BlinkDL
HF 兼容的 RWKV 权重: https://huggingface.co/RWKV
os.environ["RWKV_JIT_ON"] = '1'
os.environ["RWKV_CUDA_ON"] = '0' # 若为 '1',则对 seq 模式使用 CUDA kernel(快得多)
from rwkv.model import RWKV                         # pip install rwkv
model = RWKV(model='/fsx/BlinkDL/HF-MODEL/rwkv-4-pile-1b5/RWKV-4-Pile-1B5-20220903-8040', strategy='cuda fp16')

out, state = model.forward([187, 510, 1563, 310, 247], None)   # 使用 20B_tokenizer.json
print(out.detach().cpu().numpy())                   # 获得 logits
out, state = model.forward([187, 510], None)
out, state = model.forward([1563], state)           # RNN 有状态(如需克隆请使用 deepcopy)
out, state = model.forward([310, 247], state)
print(out.detach().cpu().numpy())                   # 与上面结果相同
nanoRWKV:https://github.com/BlinkDL/nanoRWKV (无需自定义 CUDA kernel 即可训练,适用于任何 GPU/CPU)
优秀社区 RWKV 项目:
所有(400+)RWKV 项目:https://github.com/search?o=desc&q=rwkv&s=updated&type=Repositories
- https://github.com/OpenGVLab/Vision-RWKV 视觉 RWKV
- https://github.com/feizc/Diffusion-RWKV 扩散 RWKV
- https://github.com/cgisky1980/ai00_rwkv_server 最快的 WebGPU 推理(nVidia/AMD/Intel)
- https://github.com/cryscan/web-rwkv ai00_rwkv_server 的后端
- https://github.com/saharNooby/rwkv.cpp 快速的 CPU/cuBLAS/CLBlast 推理:int4/int8/fp16/fp32
- https://github.com/JL-er/RWKV-PEFT lora/pissa/Qlora/Qpissa/state tuning
- https://github.com/RWKV/RWKV-infctx-trainer Infctx 训练器
- https://github.com/daquexian/faster-rwkv
- https://github.com/mlc-ai/mlc-llm/pull/1275
- https://github.com/TheRamU/Fay/blob/main/README_EN.md 带 RWKV 的数字助手
- https://github.com/harrisonvanderbyl/rwkv-cpp-cuda 使用 cuda/amd/vulkan 的快速 GPU 推理
250 行实现 RWKV v6(含 tokenizer):https://github.com/BlinkDL/ChatRWKV/blob/main/RWKV_v6_demo.py
250 行实现 RWKV v5(含 tokenizer):https://github.com/BlinkDL/ChatRWKV/blob/main/RWKV_v5_demo.py
150 行实现 RWKV v4(模型、推理、文本生成):https://github.com/BlinkDL/ChatRWKV/blob/main/RWKV_in_150_lines.py
RWKV v4 预印本 https://arxiv.org/abs/2305.13048
RWKV v4 介绍,以及 100 行 numpy 实现:https://johanwind.github.io/2023/03/23/rwkv_overview.html https://johanwind.github.io/2023/03/23/rwkv_details.html


RWKV v6 图解:


一篇使用 RWKV 的精彩论文(脉冲神经网络):https://github.com/ridgerchu/SpikeGPT
欢迎加入 RWKV Discord https://discord.gg/bDSBUMeFpc 一起构建。我们现在有充足的计算资源(A100 40G,感谢 Stability 和 EleutherAI),如果你有有趣的想法我可以帮你运行。

RWKV 在 Pile 中 10000 篇 ctx4k+ 文档上的 [loss vs token 位置]。RWKV 1B5-4k 在 ctx1500 之后基本平坦,但 3B-4k、7B-4k 和 14B-4k 有一些斜率,且正在变好。这推翻了 RNN 无法建模长上下文长度的旧观点。我们可以预测 RWKV 100B 会很出色,RWKV 1T 可能就是你所需要的 :)

RWKV 14B ctx8192 的 ChatRWKV:

我相信 RNN 是基础模型的更好候选,因为:(1) 对 ASIC 更友好(无 kv cache)。(2) 对 RL 更友好。(3) 当我们写作时,我们的大脑更类似于 RNN。(4) 宇宙也像 RNN(因为局部性)。Transformer 是非局部模型。
RWKV-3 1.5B 在 A40(tf32)上 = 恒定 0.015 秒/token,使用简单 pytorch 代码测试(无 CUDA),GPU 利用率 45%,显存 7823M
GPT2-XL 1.3B 在 A40(tf32)上 = 0.032 秒/token(ctxlen 1000),使用 HF 测试,GPU 利用率也是 45%(有趣),显存 9655M
训练速度:(新训练代码)RWKV-4 14B BF16 ctxlen4096 = 114K tokens/s(8x8 A100 80G,ZERO2+CP)。(旧训练代码)RWKV-4 1.5B BF16 ctxlen1024 = 106K tokens/s(8xA100 40G)。
我也在做图像实验(例如:https://huggingface.co/BlinkDL/clip-guided-binary-autoencoder),RWKV 将能做 txt2img 扩散 :) 我的想法:256x256 rgb 图像 -> 32x32x13bit 隐变量 -> 应用 RWKV 计算 32x32 网格中每个位置的转移概率 -> 假装网格独立,使用这些概率进行 "扩散"。
训练平滑——无 loss spike!(lr 和 bsz 在 15G tokens 附近改变)


所有训练好的模型都将开源。推理非常快(只有矩阵-向量乘法,无矩阵-矩阵乘法),即使在 CPU 上也是如此,所以你甚至可以在手机上运行 LLM。
工作原理:RWKV 将信息收集到若干通道中,这些通道随着你移动到下一个 token 也以不同速度衰减。一旦理解就非常简单。
RWKV 可并行化,因为每个通道的时间衰减与数据无关(且可训练)。例如,